DeepSeek 崩了两小时,把练成 App 的兜底机制考了一遍
“测试只能证明缺陷存在,永远不能证明缺陷不存在。” — 艾兹格·迪杰斯特拉《结构化编程笔记》
崩溃现场
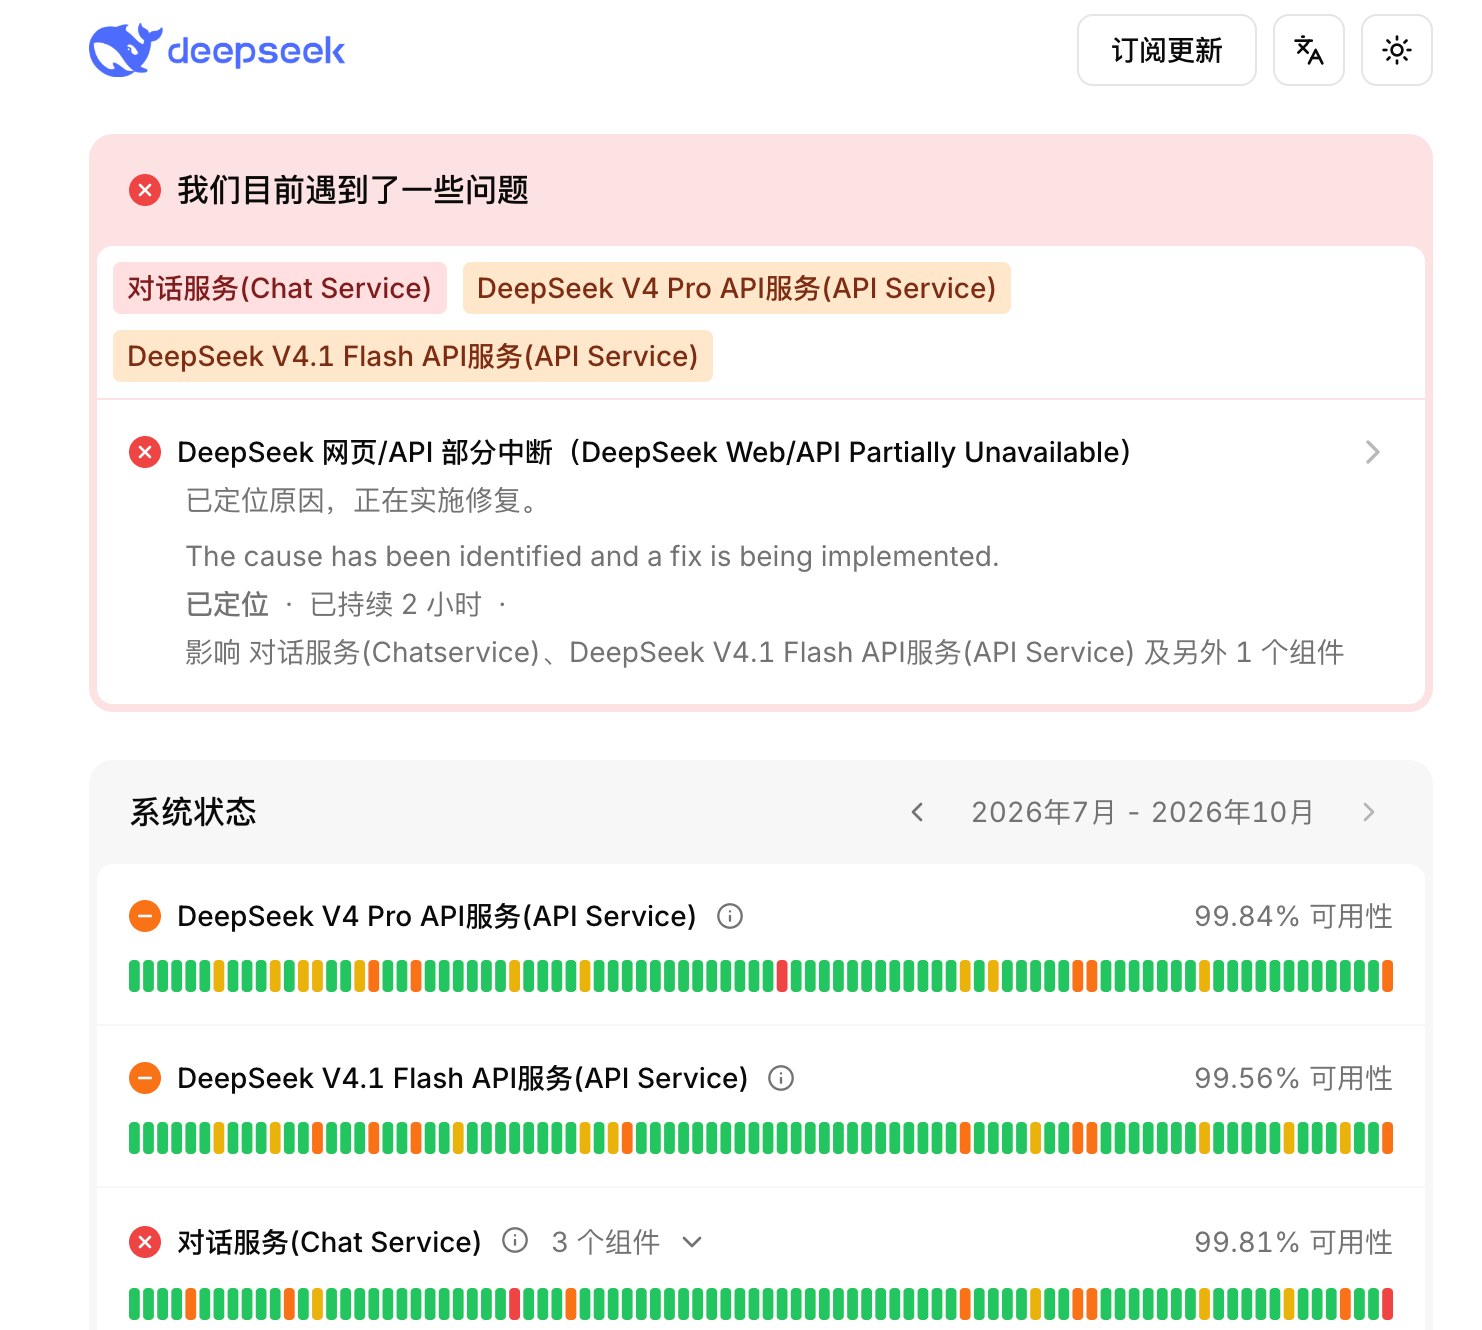
10 月 15 日,练成 App 主力的后端 LLM 平台 DeepSeek 崩了。状态页(https://status.deepseek.com/)记录得很清楚,对话服务、V4.1 Flash API 和另外 1 个组件同时中断,已持续 2 小时。
不得不说,异常事件还是有点太频繁了。
应急,先救活自己
回到我们自身。DeepSeek 的服务挂了,其实对我们不可怕,我们很早就做了大模型服务的自动 Failover。但从这次的实际效果看,并不理想,用户还是有明显的感知,得挖一挖这次暴露的问题,彻底解决一下。
进入管理页面,完成异常服务的手动摘流,确保所有流量切到健康的服务商。
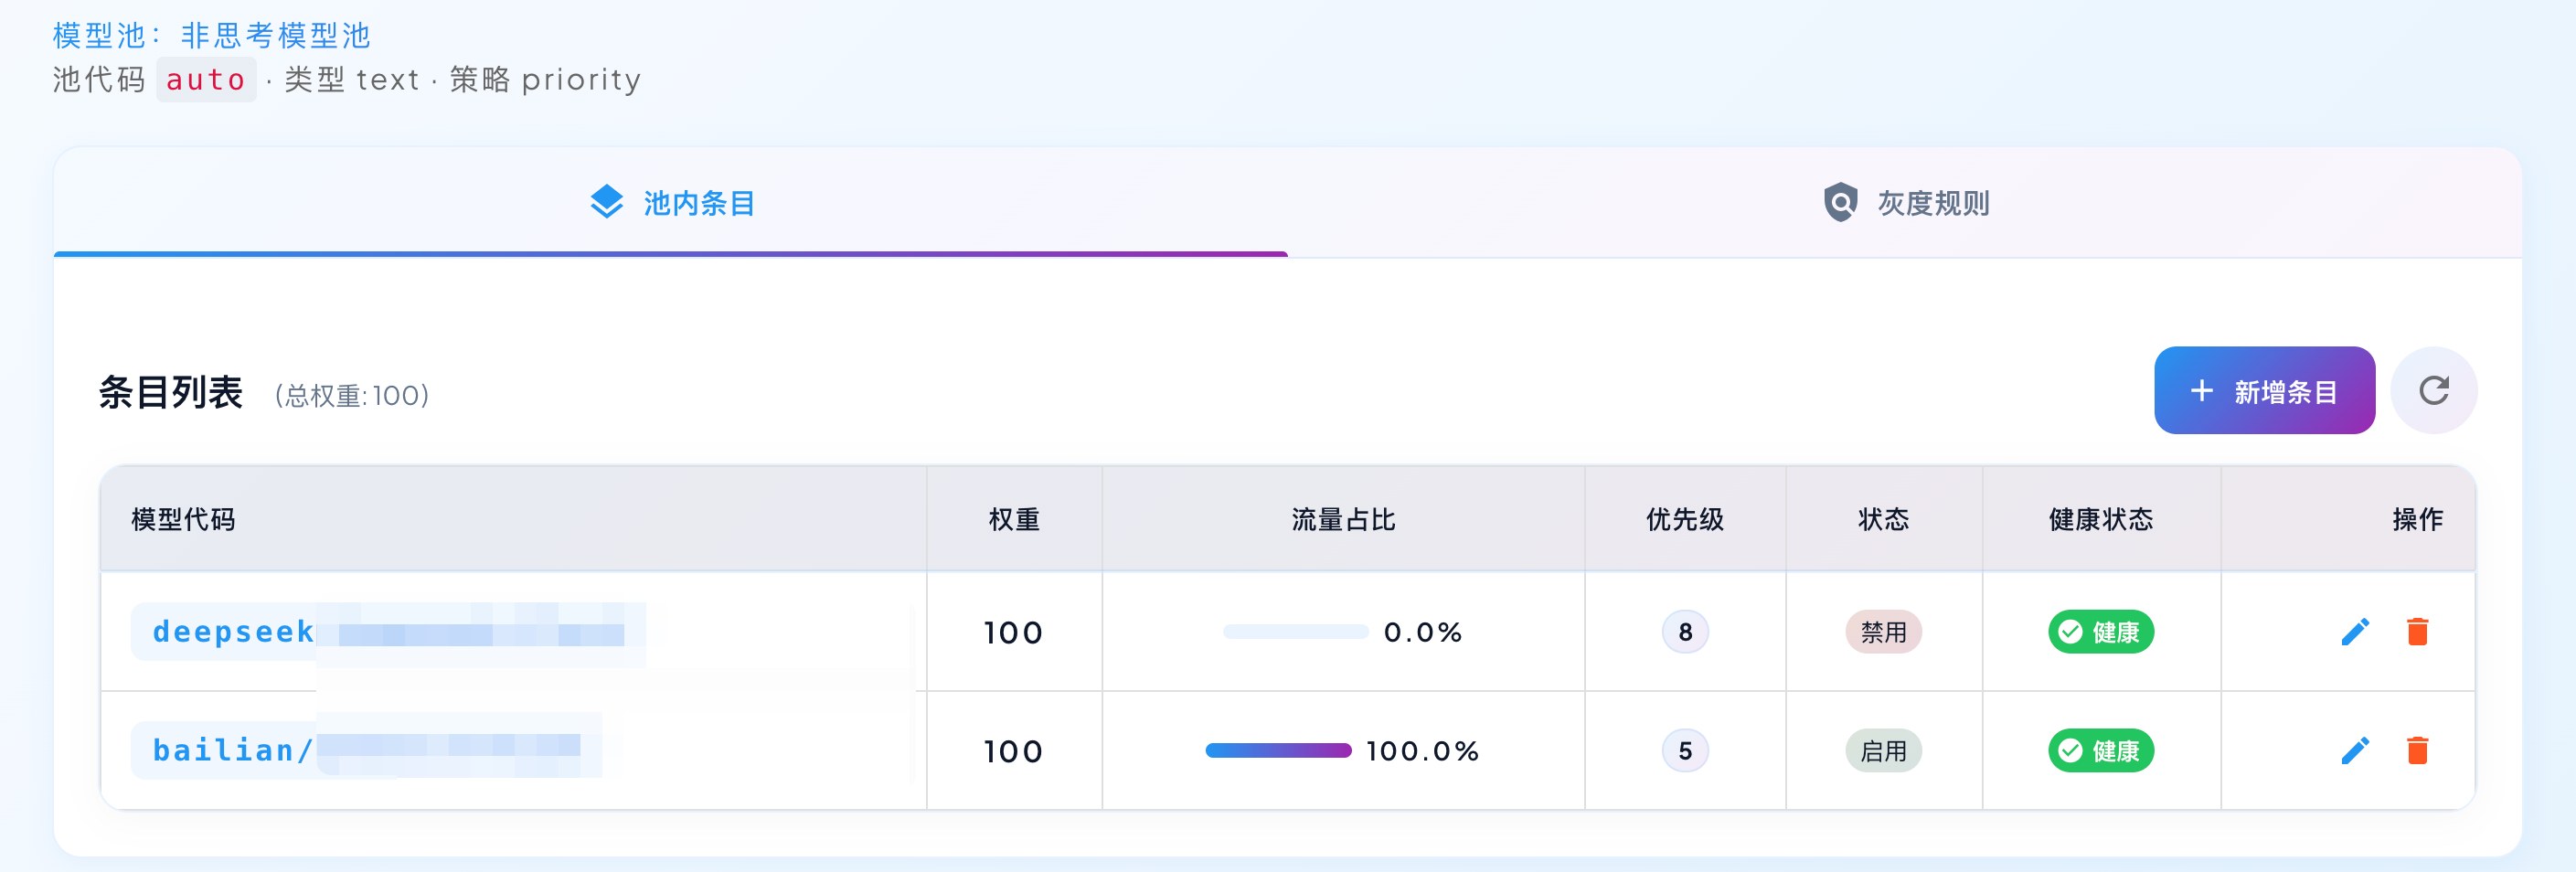
这一步做完,App 端服务已经稳定,应急完成。
App 端暴露的三个问题
异常期间,App 端各个场景的表现不一。
对话界面,底层错误直接透传
底层错误直接透传给了客户端,虽然清晰,但似乎不太友好,显得有点草台。
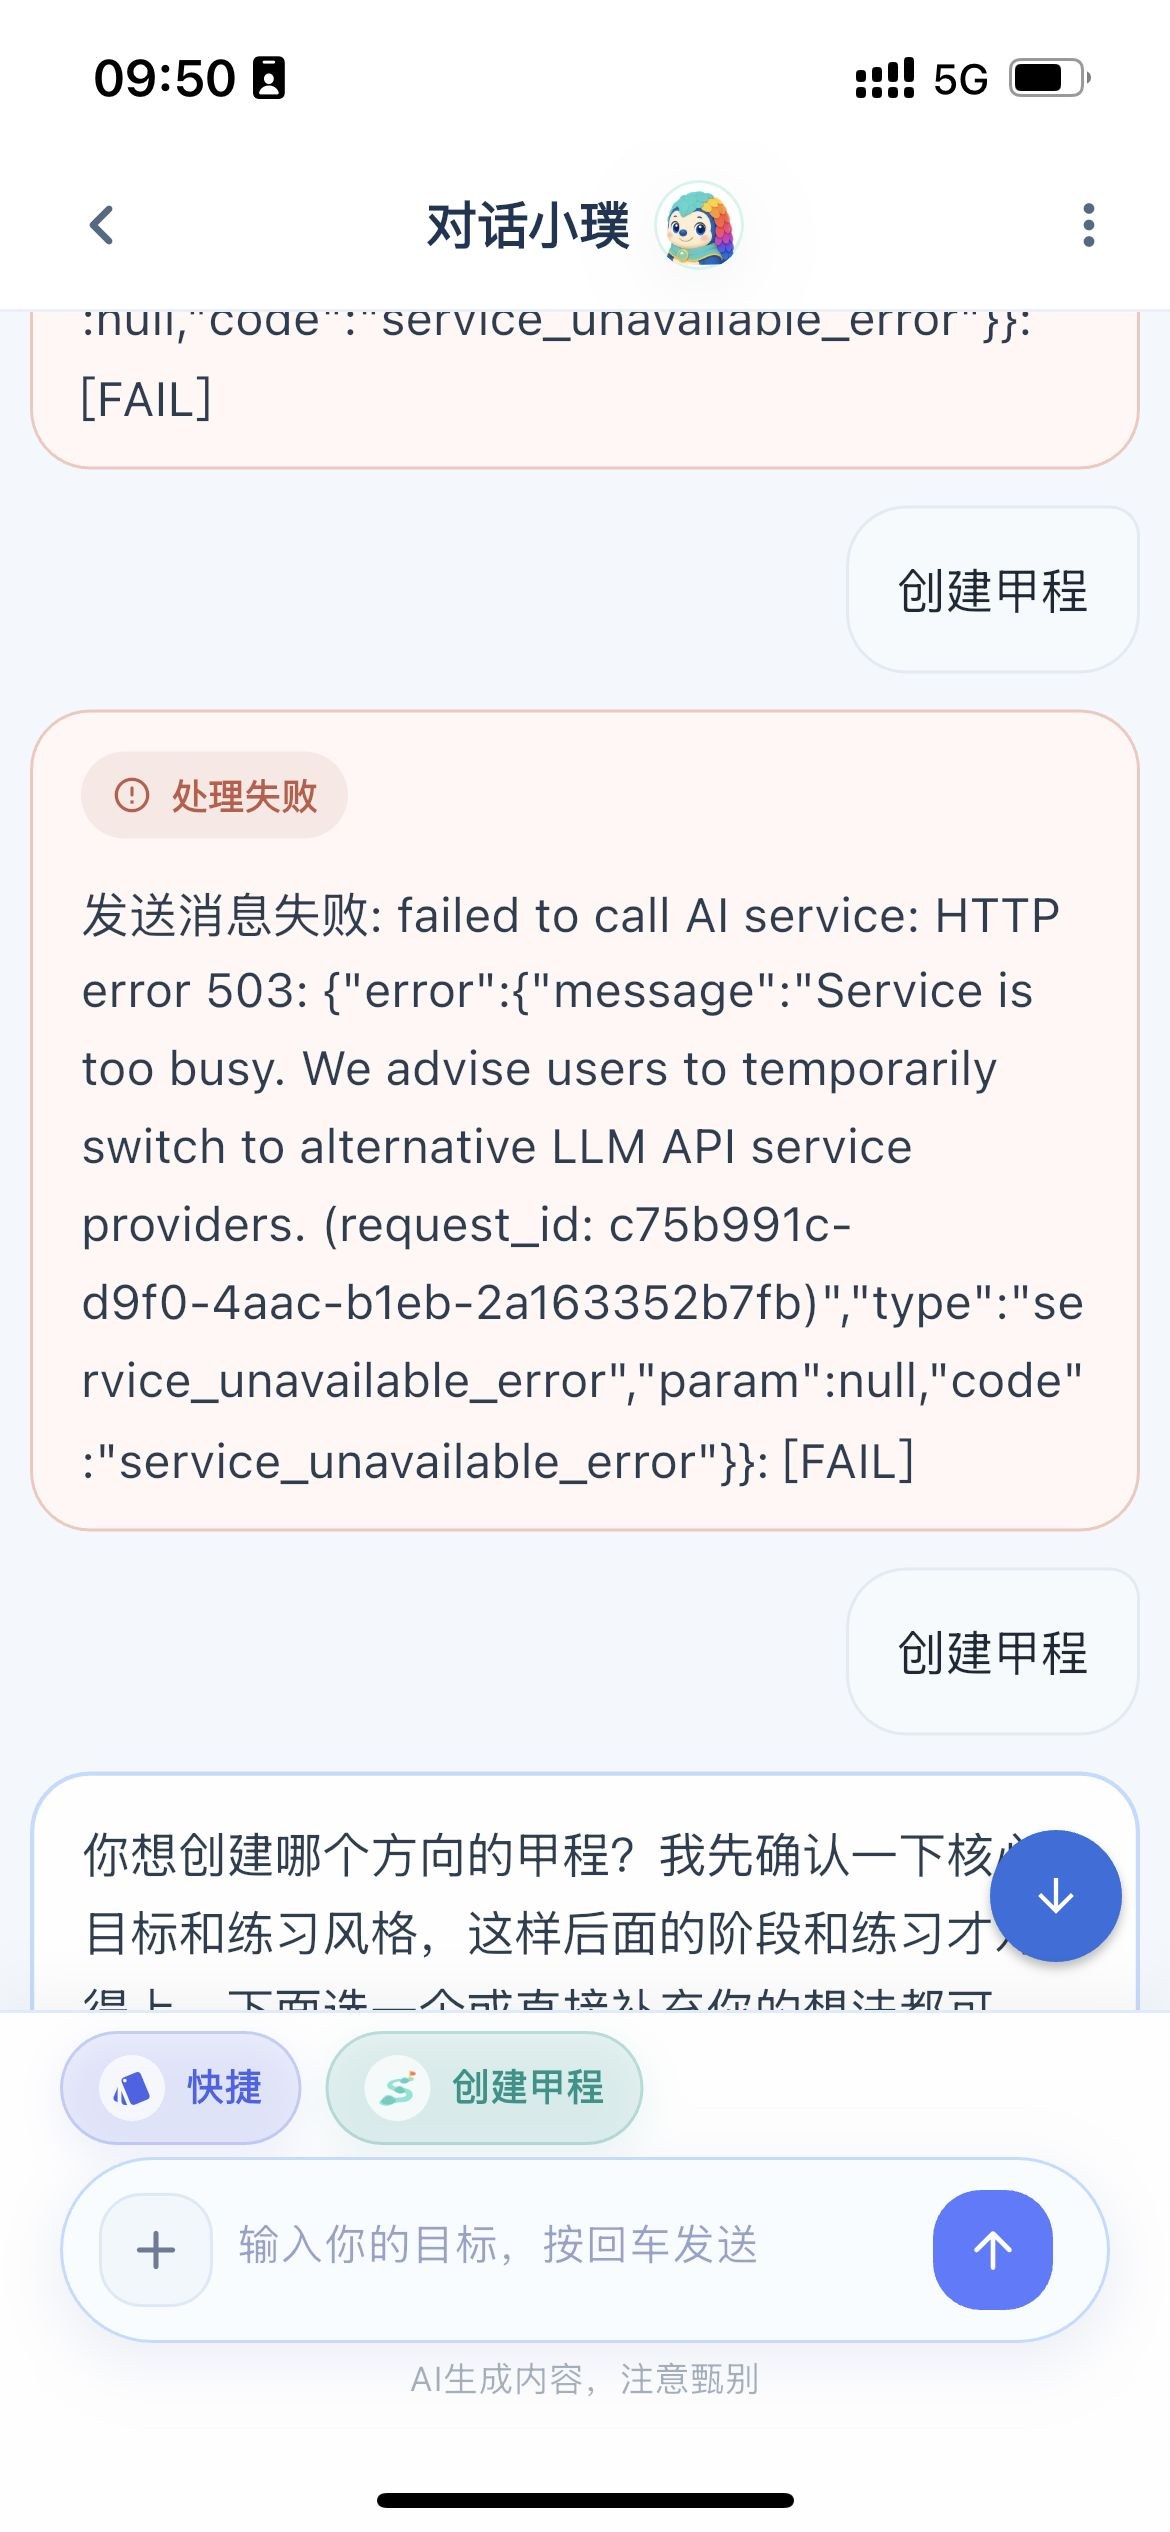
决策,后期起一个专项,对错误码做友好分类,对客更友好;对开发者来说,也需要能从错误码里快速定位问题。落地时间待定。
练习与行动场景的助手,卡住没响应
界面直接卡住,用户会不知道发生了什么事。
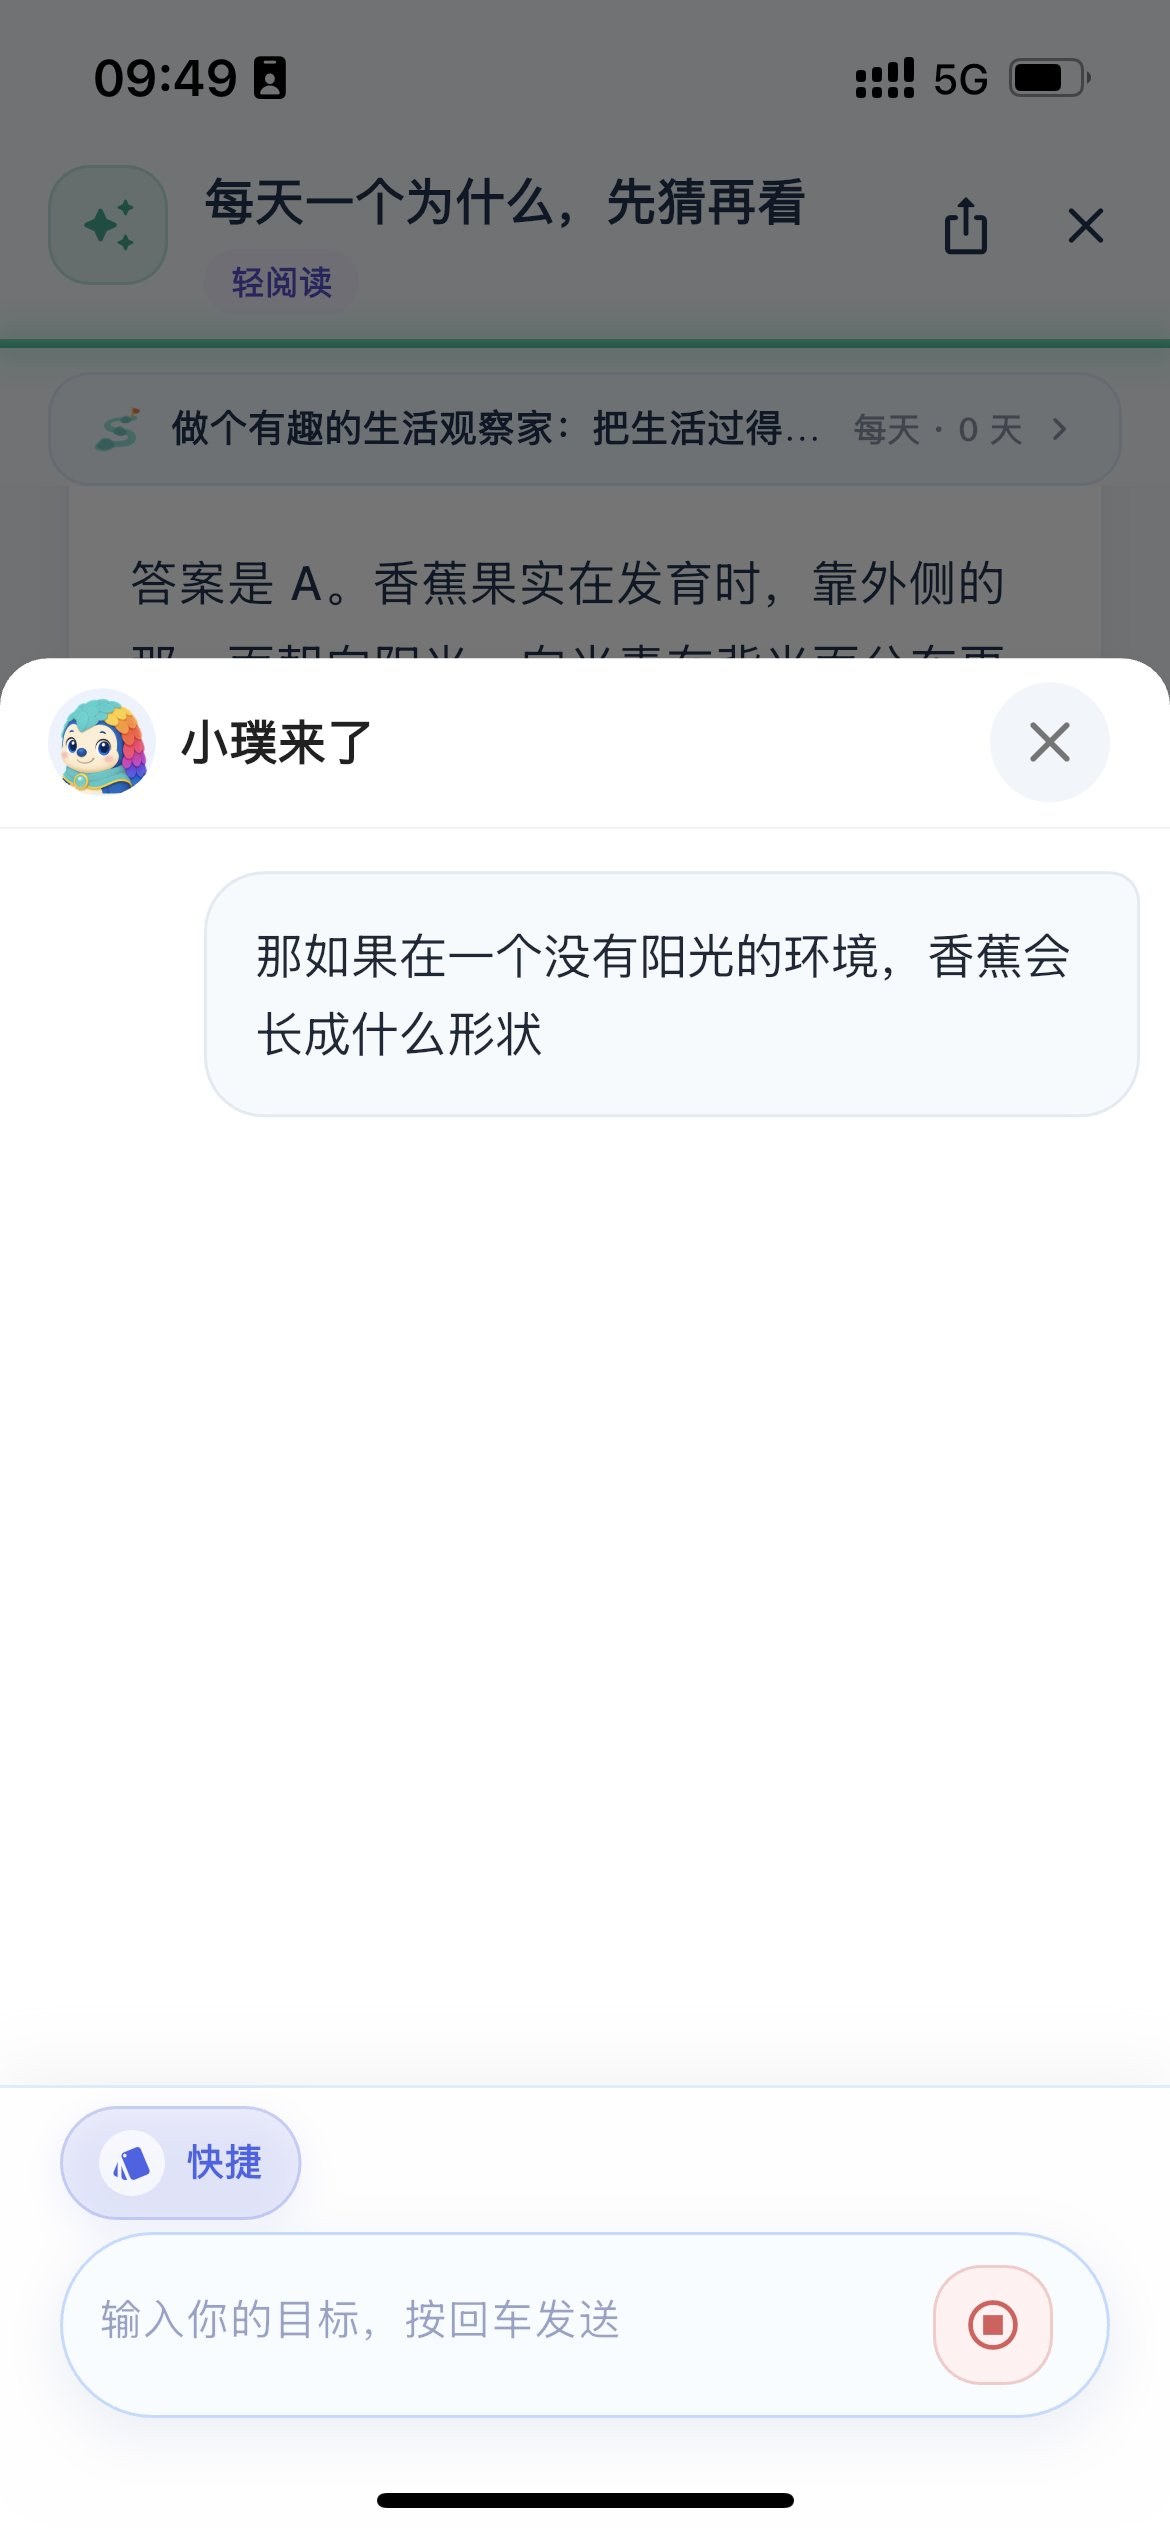
决策,需要在所有涉及网络交互的函数(包括流式对话的场景)配置合适的超时,针对不同场景评估合理的超时值。落地时间,下一个版本,11 月。
简答题评判,同样卡住
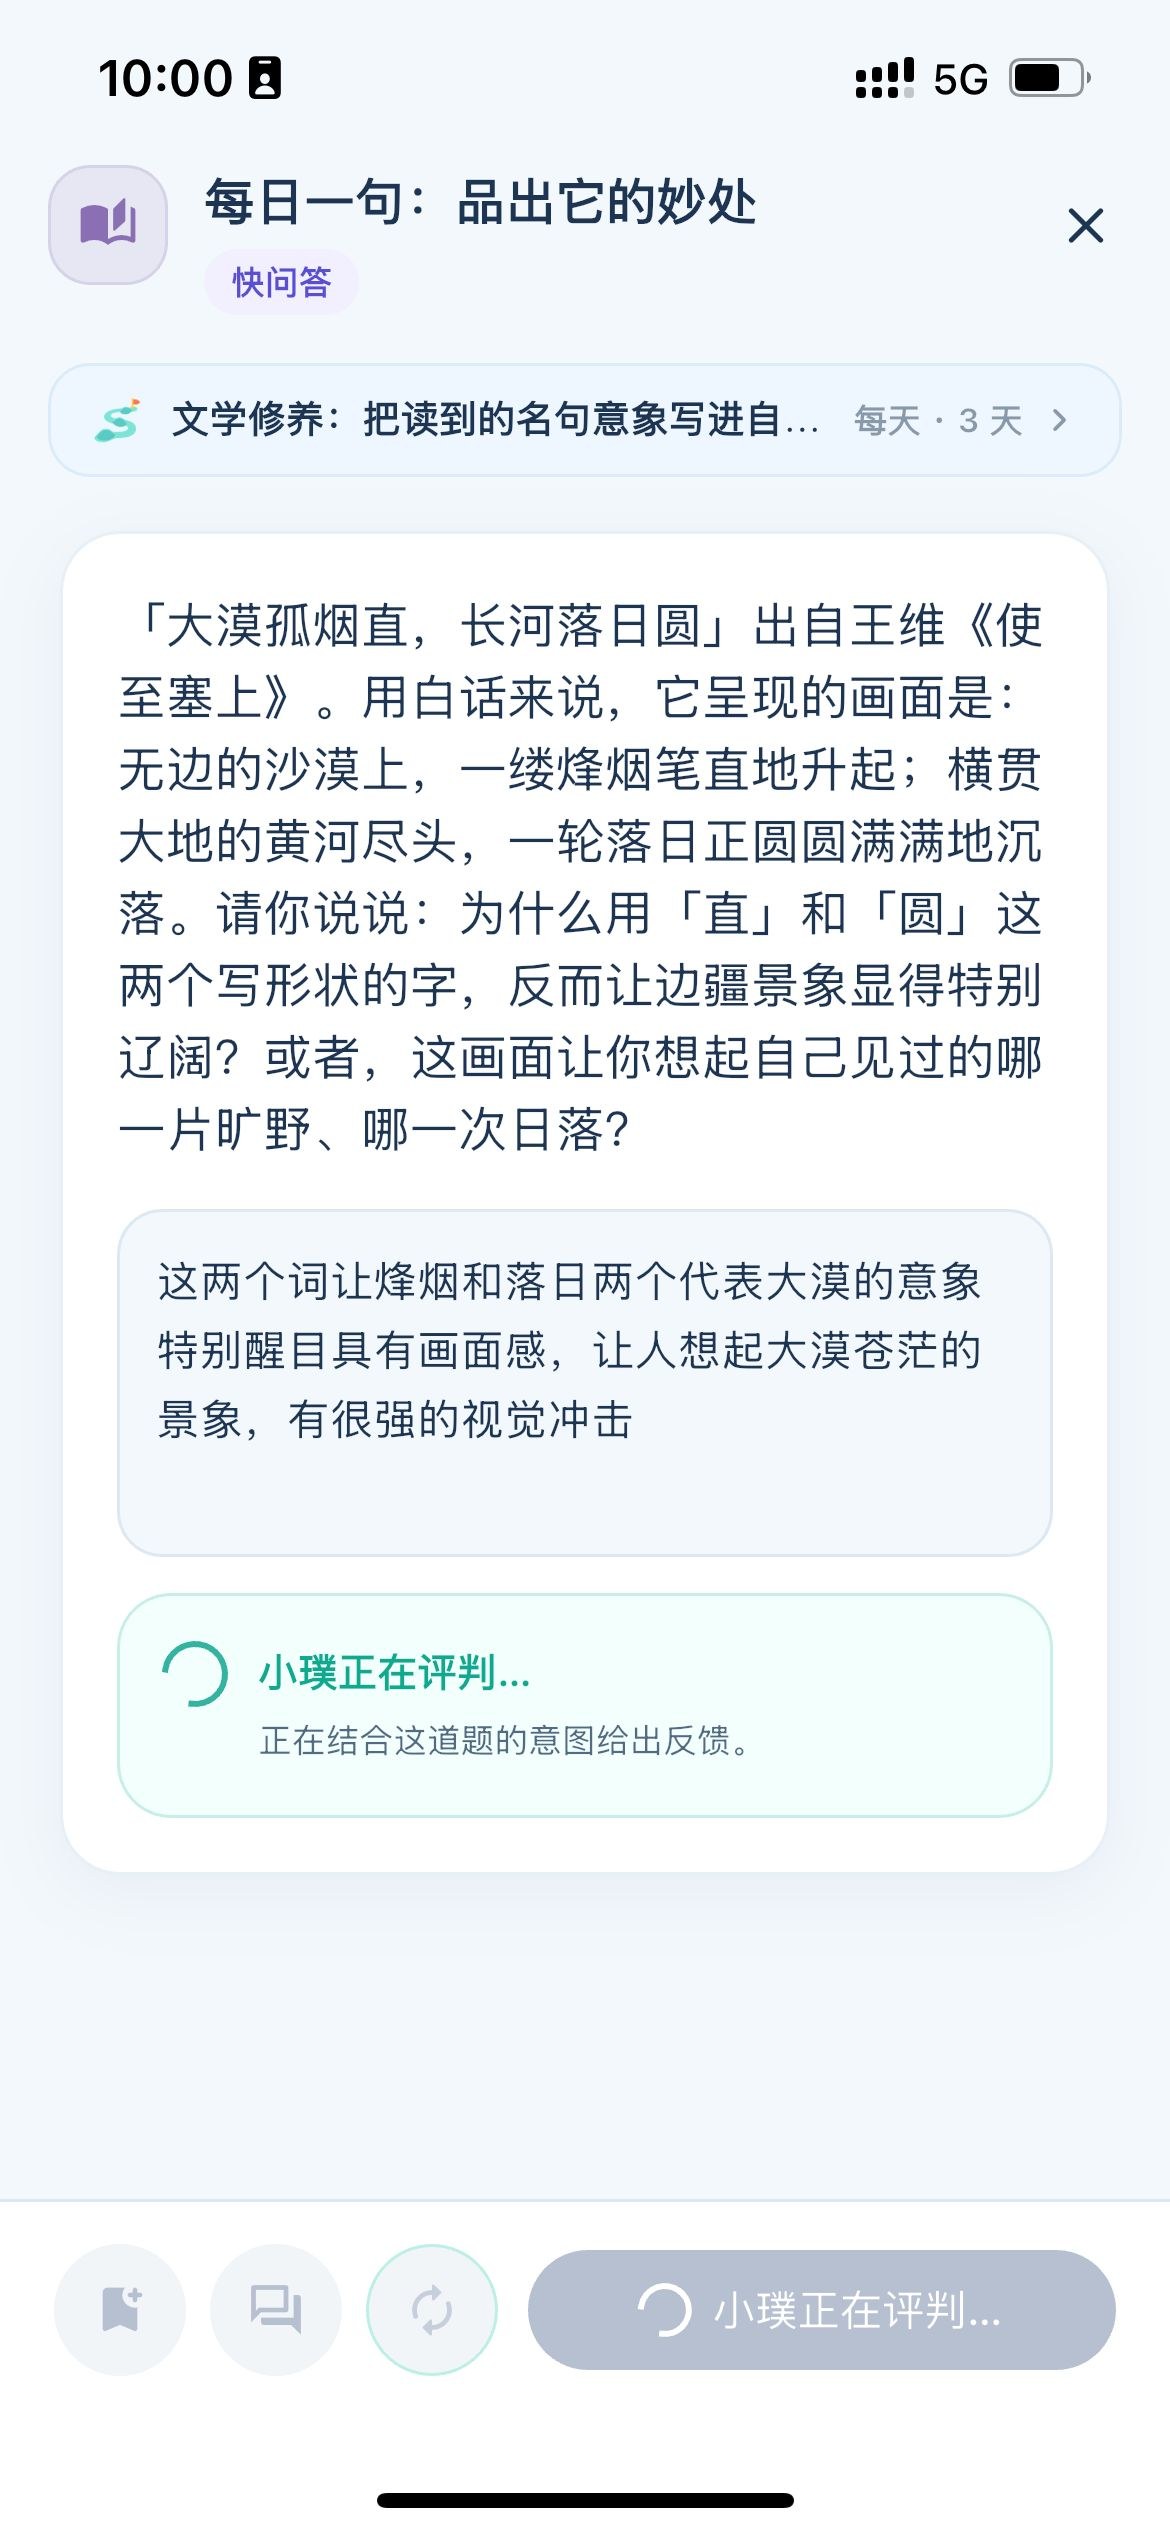
决策,同上,完善超时逻辑。
自动 Failover 为什么没接住
在引入模型池的时候,一开始就引入了自动切换恢复的机制,核心池也始终是多个配置共存。理论上应该具备单个供应商出错后自动切换的能力,但这次的实际效果有一些欠缺,体现在三处。
一是切换确实发生了,但是耗时长。二是切换后的异常情况存在误标记,导致来回切换。三是对故障的识别不够准。
这次让编码 Agent 重新复盘了整个代码逻辑,并针对性地完成了修复。
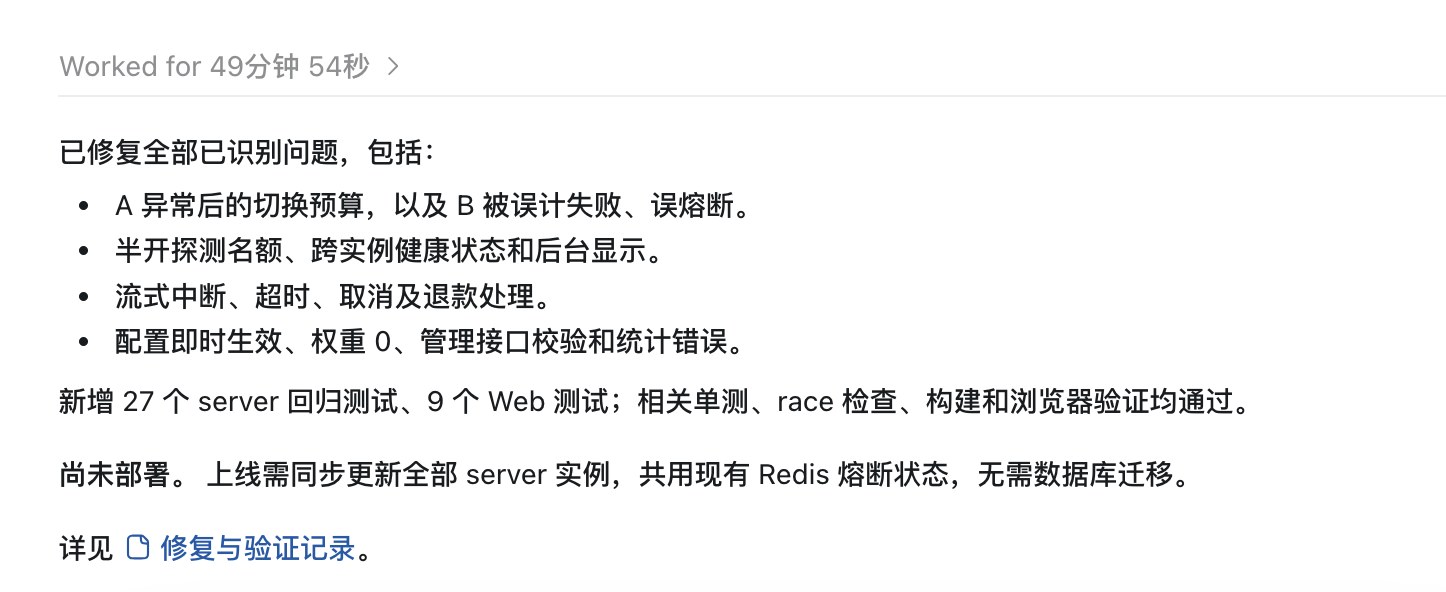
截图时还没有部署,随后完成自测并上线。
其他问题
告警没响
本次的问题没有及时告警出来,监控也有一部分缺失,稳定性基础还得继续加强。
决策,一周内把核心指标告警补齐,监控在手机端也能看。
缺一个自己的 status 页面
之前已经有设计,但是没有落地。外部探针的能力其实已经具备,需要完整搭建起来,做到可用。
决策,一周内搭建起 https://status.pracmo.com ,这也是监控的一部分。
小结
每一次真实问题都是一次小考,尽快查漏补缺,把稳定性这条线守住。
附上一份练成 App 新增的改造清单。用自己的 App 来监督自己的甲程,也就是目标之路,也算一个闭环了。